ImageToTextTask vs VisionEngine: Elija un solucionador de CAPTCHA de imagen

Lucas Mitchell
Automation Engineer
TL;DR
- Elige una tarea de CAPTCHA de imagen según su entrada y salida documentadas, en lugar de por el hecho de que el desafío contenga una imagen.
- ImageToTextTask es el punto de partida para el reconocimiento de texto; VisionEngine proporciona módulos con formas de resultado específicas.
- VisionEngine no es exclusivamente geométrico: su ejemplo documentado
ocr_gifdevuelve texto. - Ambas familias de tareas devuelven resultados de reconocimiento directamente desde
createTask; no se debe agregar una etapa de sondeo de forma predeterminada. - Valida el reconocimiento por separado de la forma en que la aplicación utiliza la respuesta, especialmente cuando intervienen coordenadas, dimensiones de imagen o desafíos renovados.
¿Cuál es la diferencia entre ImageToTextTask y VisionEngine?
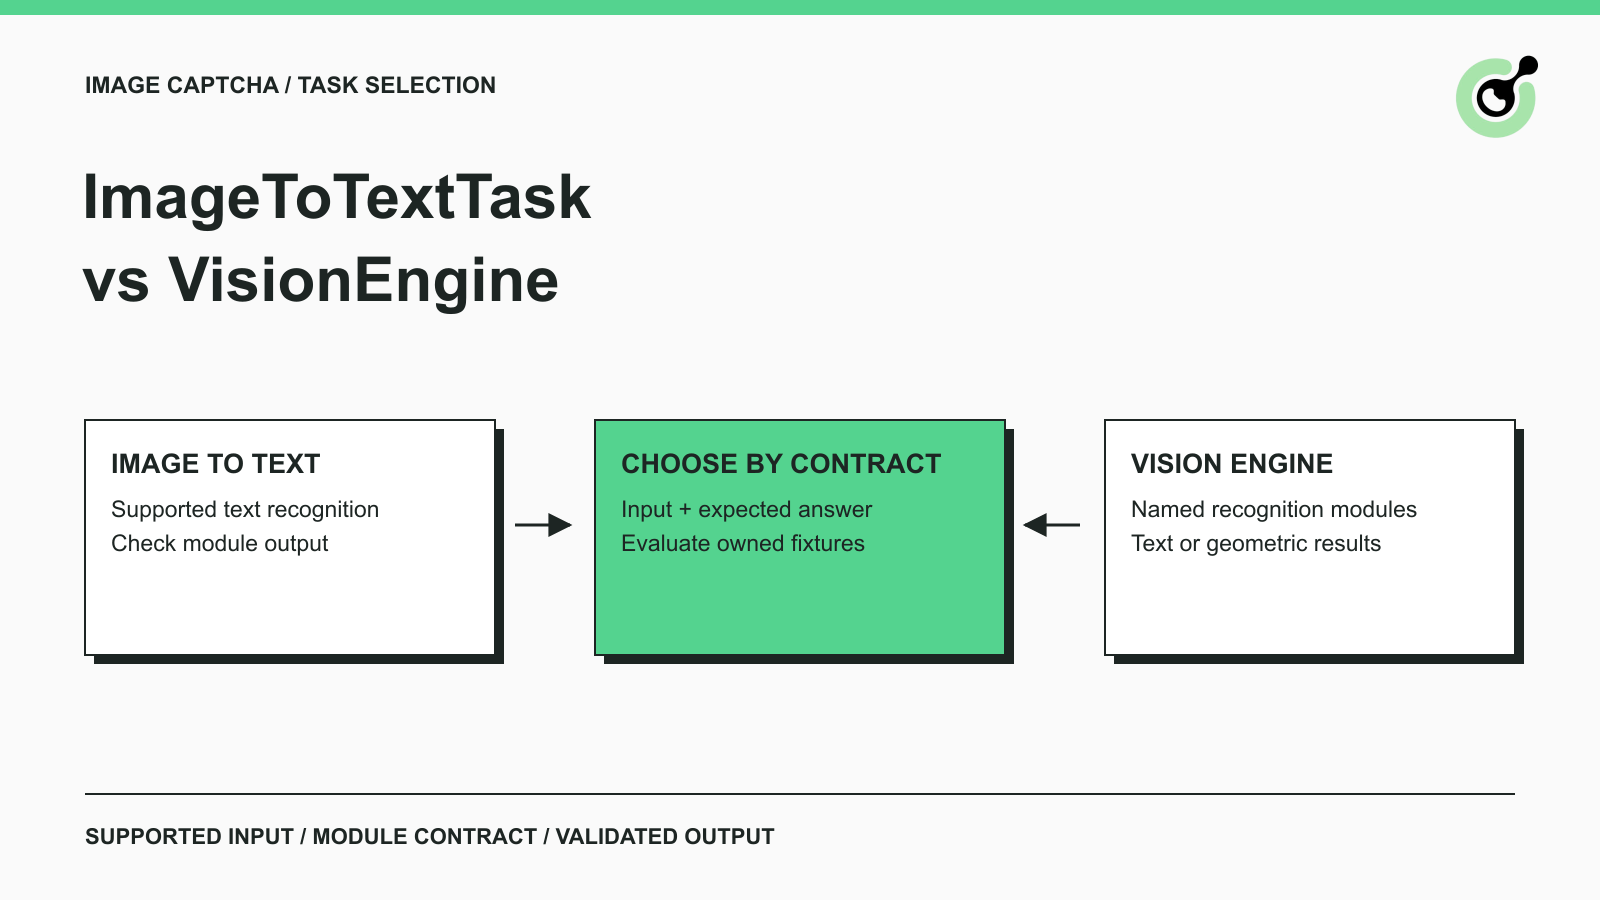
ImageToTextTask y VisionEngine son familias de tareas de reconocimiento de imágenes con campos de solicitud y respuestas específicas del módulo. La elección correcta depende del formato del desafío que soporte su aplicación autorizada y de la respuesta que necesite su aplicación a continuación.
En CapSolver, seleccionar la familia correcta implica más que cambiar el nombre de la tarea. Un analizador que espera caracteres reconocidos no puede consumir con seguridad una distancia o un ángulo. Por el contrario, una respuesta geométrica es innecesaria cuando el siguiente paso de la aplicación simplemente compara una cadena reconocida con un fixture de prueba conocido.
Reconocimiento óptico de caracteres, o OCR, extrae texto de una imagen. Eso ayuda a explicar una categoría de reconocimiento de CAPTCHA, pero "CAPTCHA de imagen" es más amplio que OCR. Un desafío puede pedir texto, una posición o otra relación visual soportada.
Este guía compara contratos y decisiones de evaluación documentados. Sus escenarios se refieren a fixtures de CAPTCHA propios y a QA permitidos. No presenta un script genérico para interactuar con sitios web arbitrarios ni afirma que un resultado de reconocimiento complete un desafío de navegador por sí solo.
Compara los contratos de tarea antes de elegir
El contrato de tarea determina qué datos de imagen envía y cómo interpreta el resultado.
| Comparación | ImageToTextTask | VisionEngine |
|---|---|---|
| Campo de imagen de solicitud principal | body |
image |
| Selección de tarea | ImageToTextTask, con opciones de módulo documentadas |
VisionEngine más un módulo nombrado soportado |
| Salida esperada | Texto o respuestas específicas del módulo | Resultados de texto o geométricos específicos del módulo |
| Entrega de resultados | Respuesta directa de createTask | Respuesta directa de createTask |
| Pregunta de integración principal | ¿El modo de reconocimiento seleccionado coincide con la respuesta esperada? | ¿El módulo exacto coincide con el formato de imagen y el contrato de salida? |
| Suposición no segura | Cada respuesta es una sola cadena de texto | Cada imagen puede usar el mismo módulo o analizador |
La referencia de ImageToTextTask documenta contenido de imagen en Base64 en body, sin saltos de línea ni prefijo de data-URI. Sus ejemplos distinguen text de answers específicos del módulo. Lea la respuesta del módulo seleccionado en lugar de aplanar cada resultado exitoso en una sola cadena.
La referencia de VisionEngine documenta módulos nombrados: ejemplos incluyen slider_1 que devuelve distance, módulos de rotación que devuelven angle, y botdeflector que devuelve points. El ejemplo ocr_gif devuelve text. La tabla general lista imageBackground como requerida, mientras que varios ejemplos de módulo la omiten. Resuelva esa diferencia contra el ejemplo exacto del módulo y confirme cualquier ambigüedad restante antes de la implementación.
Estos ejemplos establecen contratos soportados, no comprensión de imagen universal. Un nombre de tarea no es permiso para inventar un módulo, agregar un prompt de forma libre o esperar un tipo de respuesta que el módulo seleccionado no documente.
¿Cuándo deberías comenzar con ImageToTextTask?
Comienza con ImageToTextTask cuando la respuesta útil del desafío soportado sea texto reconocido y el módulo documentado se ajuste a tu entrada.
Supongamos que tu equipo mantiene un formulario de contacto heredado y tiene un conjunto de prueba permitido de imágenes de caracteres. La pregunta de evaluación es específica: ¿la ruta de reconocimiento devuelve los caracteres esperados por el fixture? Puedes comparar la cadena devuelta con la etiqueta de prueba sin involucrar coordenadas del navegador ni movimiento del puntero.
Define las reglas de texto de la aplicación antes de evaluar el solucionador. ¿Distingue tu formulario entre mayúsculas y minúsculas? ¿Mantiene los ceros iniciales? ¿Acepta espacios? Estas son propiedades de la aplicación que controlas. No deberían cambiarse silenciosamente por una función de limpieza genérica de resultados.
Por ejemplo, una etiqueta de fixture "007A" debe permanecer como una cadena durante la comparación. Tratar su resultado como un número haría que el analizador de la aplicación fuera responsable de un error evitable. Este es un ejemplo de validación ilustrativo, no un resultado de solucionador reportado.
Mantén distinguibles los resultados vacíos y las formas de respuesta incorrectas. Una campo esperado faltante es un problema de integración para inspeccionar. Una respuesta correctamente formada pero incorrecta pertenece a la evaluación de reconocimiento. Combinar ambas en un solo "índice de precisión" oculta si el problema radica en la elección de tarea o en el reconocimiento de imagen.
¿Cuándo merece la pena evaluar VisionEngine?
Evalúa VisionEngine cuando un módulo documentado se ajuste al formato del desafío y su estructura devuelta sea la información que necesita tu aplicación.
En una prueba de imagen controlada, un ángulo y una lista de puntos representan afirmaciones diferentes. Un ángulo puede compararse con la orientación esperada del fixture. Una lista de puntos necesita sus propias reglas de interpretación. Ninguno debe pasar por un analizador escrito para reconocimiento de caracteres.
Prepara un adaptador específico del módulo con una responsabilidad deliberadamente estrecha: acepta la forma de resultado documentada, válidala y entrega la respuesta interpretada a la aplicación propia. No hagas que ese adaptador decida qué control de navegador no relacionado operar. Mantener la interpretación de reconocimiento separada hace que los fallos sean más fáciles de reproducir con fixtures almacenados.
La presencia de un módulo OCR también evita una regla simplista como "el texto siempre significa ImageToTextTask". Para entradas de texto animado, inspecciona el formato y módulo soportado documentado antes de elegir. Solo el formato de respuesta no establece que dos tareas acepten las mismas entradas o funcionen igual de bien en ellas.
Si ningún módulo documentado se ajusta al desafío, regístralo como no soportado o no resuelto. Cambiar etiquetas de solicitud hasta que una API acepte el payload no es un método confiable de evaluación. La aceptación de una solicitud no establece que su modelo de reconocimiento se ajuste a la imagen.
Redime tu código de bonificación de CapSolver
¡Aumenta tu presupuesto de automatización instantáneamente!
Usa el código de bonificación CAP26 al recargar tu cuenta de CapSolver para obtener un 5% adicional en cada recarga — sin límites.
Redímelo ahora en tu Panel de CapSolver

¿Cómo debe afectar la preparación de imágenes a la comparación?
La preparación de imágenes debe preservar la evidencia que necesita cada tarea candidata, para que la evaluación mida el ajuste de la tarea en lugar de diferencias accidentales en el preprocesamiento.
Base64 es una representación de bytes. La especificación Base64 RFC 4648 define esa codificación; no establece que el archivo codificado sea la imagen correcta para un módulo de reconocimiento. Un payload puede estar codificado sintácticamente y aún contener un desafío caducado, una recortada incorrecta o un formato de imagen no soportado.
Para cada fixture propio, conserva una referencia a la imagen original y anota cualquier transformación realizada antes de la entrega. Ejemplos incluyen redimensionar, aplanar una animación o cambiar un recorte. Evita aplicar silenciosamente la misma transformación a cada familia de tareas: eliminar marcos de animación puede cambiar la información disponible para una tarea diseñada para entrada animada.
Si un módulo evaluado necesita imágenes de primer plano y fondo, asegúrate de que pertenezcan a la misma instancia de fixture. Combinar un primer plano de una renovación con un fondo de otra crea una entrada inadecuada. Ese fallo no debe contarse como evidencia de que un módulo válido sea inexacto.
Usa imágenes de prueba sintéticas o aprobadas sin información personal no relacionada. Una captura de pantalla de toda una página de soporte puede contener más de lo que el desafío requiere. Limitar la imagen enviada al input permitido hace que la prueba sea más clara y reduce la exposición innecesaria de datos.
¿Por qué los resultados de coordenadas son más difíciles de integrar que el texto?
Los resultados de coordenadas requieren un acuerdo sobre el marco de referencia de la imagen y el diseño antes de que la aplicación los use correctamente.
Un punto medido contra una imagen original no es automáticamente un punto en una ventana del navegador. La definición de rectángulo del navegador describe un rectángulo relativo a la ventana y incluye el borde y el relleno del elemento. Eso es diferente de asumir que el elemento mostrado coincide exactamente con las dimensiones de la imagen sin procesar.
En un entorno de QA propio, prueba la interpretación de coordenadas como un componente separado. Registra las dimensiones del fixture, las dimensiones realmente presentadas al solucionador y la representación de la aplicación usada para evaluar la respuesta. Si esas representaciones difieren, la aplicación necesita un mapeo explícito y probado adecuado a su propia interfaz.
No uses una respuesta de reconocimiento exitosa como prueba de que ese mapeo sea correcto. Una prueba útil puede comparar el resultado interpretado con un fixture etiquetado antes de que ocurra cualquier acción del navegador. Una segunda prueba puede verificar que el componente propio consuma ese resultado interpretado como se esperaba.
Esta separación también ayuda con desafíos renovados. Si la interfaz reemplaza una imagen mientras el reconocimiento está en ejecución, la respuesta sigue perteneciendo al fixture original. Tu aplicación debe descartar esa asociación caducada en lugar de aplicar el resultado a la imagen reemplazada.
¿Cómo puedes comparar con justicia la precisión y el costo operativo?
Una comparación justa agrupa los resultados por familia de desafíos soportados y cuenta los resultados de aplicación completados por separado de las respuestas válidas de la API.
Comienza con un conjunto de fixtures representativo y autorizado. Incluye las variaciones de imagen que tu aplicación realmente produce, como sus dimensiones normales y el rango esperado de caracteres. Mantén un conjunto de validación etiquetado para la evaluación para que los ajustes en el preprocesamiento no sean juzgados solo en los mismos ejemplos que los motivaron.
Registra estas categorías por separado:
| Categoría de evaluación | Qué te dice |
|---|---|
| Entrada rechazada | Necesita atención en la solicitud o formato |
| Forma de respuesta esperada devuelta | El contrato del analizador se cumple |
| La respuesta coincide con el fixture | El reconocimiento cumple con el criterio del fixture |
| La aplicación propia acepta la respuesta | La integración preserva el significado de la respuesta |
| El resultado llega después de reemplazar el fixture | El tiempo o ciclo de vida hicieron la respuesta inútil |
No compares tareas no relacionadas usando una sola puntuación de precisión. Un fixture de texto y un fixture geométrico prueban salidas diferentes. Donde dos opciones documentadas en realidad se ajusten a la misma familia de entradas, mantén el conjunto de fixtures y la definición de éxito constantes.
En cuanto al costo, mide el gasto total contra los resultados exitosos y relevantes y considera el trabajo de ingeniería. Un analizador que requiera investigaciones manuales frecuentes puede costar tiempo incluso cuando las tarifas de tarea sean modestas. No se establece un ganador universal en precio o rendimiento solo por los nombres de campos de API.
Estas son recomendaciones de evaluación, no resultados de benchmarks. Ejecútalas contra tu aplicación autorizada antes de hacer una afirmación sobre precisión, velocidad o ahorro.
¿Qué debe contener una lista de verificación final para la selección de tarea?
Una lista de verificación para la selección de tarea debe identificar la entrada soportada, la respuesta esperada, el comportamiento de entrega y la prueba de aceptación de la aplicación.
Para cada familia de CAPTCHA soportada, documenta la tarea y módulo seleccionados, las reglas de preparación de imagen, el campo de solución esperado y lo que ocurre si la respuesta tiene otra forma. Asigna un responsable para revisar esas suposiciones cuando tu aplicación cambie su implementación de CAPTCHA.
Mantén separada la revisión de accesibilidad de la evaluación de reconocimiento. La discusión de W3C sobre la inaccesibilidad de CAPTCHA explica las barreras creadas por los mecanismos de desafío. Añadir un solucionador a un flujo de QA automatizado no demuestra que el formulario público ofrezca una experiencia accesible. El propietario del sitio aún necesita evaluar alternativas adecuadas para el usuario.
Para una explicación más amplia de la capa de reconocimiento, consulta cómo un API de reconocimiento de imagen se ajusta a la automatización de CAPTCHA personalizada. Vuelve a esta comparación al elegir el contrato de tarea preciso.
Comienza con una tarea CapSolver soportada, un pequeño conjunto de prueba etiquetado y un analizador que preserve el resultado documentado. Amplía la cobertura solo después de que cada nueva familia de entrada tenga sus propios criterios claros de aceptación.
Preguntas frecuentes
P: ¿Es VisionEngine un reemplazo de ImageToTextTask?
VisionEngine no es un reemplazo universal. Elige la tarea cuyo módulo documentado soporte la entrada y proporcione el resultado que tu aplicación espera. Formas de respuesta diferentes y requisitos de imagen pueden requerir adaptadores diferentes.
P: ¿Siempre devuelve VisionEngine coordenadas?
VisionEngine no siempre devuelve coordenadas. Sus ejemplos de módulo incluyen resultados geométricos y un ejemplo de OCR que devuelve texto. Lee el contrato de respuesta del módulo seleccionado en lugar de inferirlo a partir del nombre de la familia de tareas.
P: ¿Necesitan estas familias de tareas el sondeo getTaskResult?
Ambas referencias de familias de tareas vinculadas describen resultados devueltos directamente a través de createTask. Un wrapper de API compartido debe preservar esa solución directa en lugar de iniciar automáticamente un bucle de sondeo.
P: ¿Puede una respuesta reconocida probar que un formulario CAPTCHA funciona?
Una respuesta reconocida no demuestra ni el enrutamiento correcto de resultados ni la finalización del formulario. Valida la respuesta contra un fixture, luego verifica que la aplicación propia la consuma para el desafío correspondiente y alcance el resultado esperado.
Ver más
The Other CAPTCHASep 15, 2026
Solucionador de CAPTCHA: Barrido vs Webhooks – Cómo elegir un flujo de resultados
Elija el sondeo del solucionador de CAPTCHA o los webhooks usando el estado de la tarea, los requisitos del receptor, la frescura de los resultados y el flujo de finalización de la API CapSolver documentado.
The Other CAPTCHASep 09, 2026
Seguridad de la integración de CAPTCHA: Proteger llaves y sesiones
Aprende a proteger claves, sesiones, registros y entornos de prueba en integraciones de CAPTCHA de Selenium, con verificaciones prácticas para automatización autorizada.
