🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Sep 29, 2026
Actualizado Sep 29, 2026 · min de lectura
Los modelos de lenguaje grandes pueden convertir contenido web inconsistente en registros útiles, pero no eliminan el trabajo operativo necesario para obtener datos de página confiables. Un flujo de producción aún necesita verificaciones de permiso, límites de solicitud, ejecución del navegador cuando se requiera JavaScript, manejo explícito para puntos de verificación de verificación y validación determinista antes de que un registro llegue a una base de datos.
GLM-5.3 es útil en la capa de interpretación. Su flujo de trabajo compatible con API puede clasificar contenido renderizado, mapear texto en un esquema, explicar por qué un campo está ausente y ayudar a normalizar diferencias entre páginas. Para automatización autorizada que encuentre una tarea de verificación respaldada, CapSolver puede colocarse antes de la extracción mientras la aplicación mantiene el control de la sesión de la página y verifica el resultado final.
Este guía presenta una arquitectura genérica en lugar de instrucciones para un sitio web específico. Úsela solo para datos públicos u otros datos autorizados y deténgase cuando un flujo alcance límites de inicio de sesión, pago, datos personales o permisos fuera de su alcance aprobado.
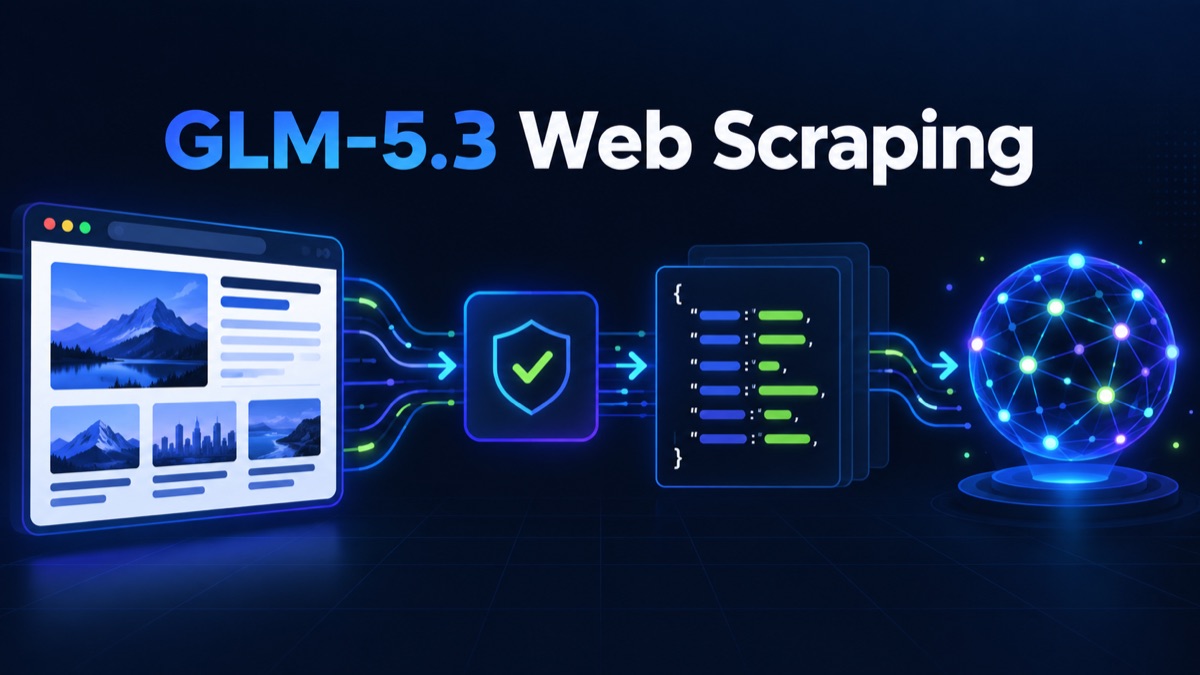
Un sistema robusto de scraping web con GLM-5.3 utiliza una secuencia de etapas pequeñas. Cada etapa produce un resultado tipado que la siguiente etapa puede verificar.
| Etapa | Responsabilidad | Salida esperada | Condición de detención |
|---|---|---|---|
| Puerta de permiso | Verificar objetivo, alcance de datos, tasa y propósito | Definición de trabajo aprobada | El alcance no está autorizado |
| Capa de acceso | Recuperar o renderizar la página | Estado, encabezados, URL final, HTML o captura de pantalla | Inicio de sesión, pago, datos privados o acceso denegado |
| Clasificador de respuesta | Identificar contenido, página vacía, límite de tasa o página de verificación | Estado de página nombrado | Estado desconocido o no admitido |
| Adaptador de verificación | Enviar una tarea documentada cuando sea permitido | Listo, en proceso o error terminal | Límite de tiempo o presupuesto de intentos alcanzado |
| Extracción de GLM | Convertir contenido permitido en un esquema estricto | Registro JSON candidato | Salida inválida o no admitida por evidencia |
| Validación determinista | Verificar tipos, campos requeridos, duplicados y evidencia de origen | Registro aceptado o rechazo explícito | Cualquier regla de negocio falla |
| Almacenamiento | Realizar escritura idempotente | ID de registro estable y enlace de seguimiento | La clave de origen ya existe sin una nueva versión |
La frontera más importante es entre acceso e interpretación. Si un modelo recibe el HTML de una página de desafío, podría describir confiadamente esa página como el contenido objetivo. Clasifica la respuesta antes de invocar al modelo.
El ejemplo de orquestación usa Python 3.11 o posterior y el paquete requests. Mantén las credenciales en variables de entorno y nunca las incluyas en código fuente, prompts, registros, capturas de pantalla o configuración comprometida.
python -m venv .venv
source .venv/bin/activate
pip install requests

export ZAI_API_KEY="reemplazar-con-tu-clave-z-ai"
export CAPSOLVER_API_KEY="reemplazar-con-tu-clave-capsolver"
La documentación oficial de la API de Z.ai usa el punto final de chat-completions en https://api.z.ai/api/paas/v4/chat/completions. Confirma el identificador de modelo actual en el repositorio de GLM-5 o en tu consola de Z.ai antes de la implementación; este guía usa glm-5.3-flash como valor predeterminado configurable en el entorno.
No pidas al modelo que "extraiga todo lo importante". Define los campos, el comportamiento permitido de nulos y los requisitos de evidencia antes de recolectar una página.
from dataclasses import dataclass
from datetime import datetime, timezone
from typing import Any

@dataclass(frozen=True)
class ExtractionJob:
    source_url: str
    allowed_host: str
    required_fields: tuple[str, ...]
    max_input_chars: int = 40_000

def validate_record(job: ExtractionJob, record: dict[str, Any]) -> dict[str, Any]:
    missing = [name for name in job.required_fields if not record.get(name)]
    if missing:
        raise ValueError(f"missing_required_fields:{','.join(missing)}")
    if record.get("source_url") != job.source_url:
        raise ValueError("source_url_mismatch")
    record["validated_at"] = datetime.now(timezone.utc).isoformat()
    return record
El modelo solo puede devolver null cuando el esquema lo permita explícitamente. Los valores requeridos deben confirmarse contra la evidencia de la página mediante código ordinario.
La capa de acceso debe devolver un pequeño objeto de estado en lugar de solo una cadena de HTML. El clasificador puede usar códigos de estado, URL final, tipo de contenido, selectores esperados y marcadores conocidos de puntos de verificación.
from enum import Enum

class PageState(str, Enum):
    CONTENT = "content"
    JAVASCRIPT_REQUIRED = "javascript_required"
    RATE_LIMITED = "rate_limited"
    LOGIN_REQUIRED = "login_required"
    VERIFICATION = "verification"
    UNKNOWN = "unknown"

def choose_action(state: PageState) -> str:
    return {
        PageState.CONTENT: "extract",
        PageState.JAVASCRIPT_REQUIRED: "render_in_authorized_browser",
        PageState.RATE_LIMITED: "back_off",
        PageState.LOGIN_REQUIRED: "stop_for_operator",
        PageState.VERIFICATION: "evaluate_supported_task",
        PageState.UNKNOWN: "stop_for_review",
    }[state]
Los códigos HTTP 403 y 429 no deben entrar en un bucle de reintentos genérico. Una solicitud rechazada requiere una revisión de permisos y configuración. Una solicitud limitada requiere una reducción de concurrencia global y respeto por cualquier ventana de reintentos proporcionada por el servidor.
La API oficial de CapSolver usa createTask para enviar una tarea documentada. Las tareas asincrónicas se verifican con getTaskResult. La aplicación debe seleccionar el tipo de tarea del documento actual task documentation y pasar solo los campos necesarios para ese punto de verificación permitido.
import os
import time
import requests

CAPSOLVER_BASE = "https://api.capsolver.com"

def solve_supported_task(task: dict, *, timeout_seconds: int = 45) -> dict:
    api_key = os.environ["CAPSOLVER_API_KEY"]
    created = requests.post(
        f"{CAPSOLVER_BASE}/createTask",
        json={"clientKey": api_key, "task": task},
        timeout=15,
    ).json()
    if created.get("errorId") != 0:
        raise RuntimeError(created.get("errorCode", "create_task_failed"))
    if created.get("status") == "ready":
        return created["solution"]

    task_id = created.get("taskId")
    if not task_id:
        raise RuntimeError("missing_task_id")

    deadline = time.monotonic() + timeout_seconds
    while time.monotonic() < deadline:
        time.sleep(3)
        result = requests.post(
            f"{CAPSOLVER_BASE}/getTaskResult",
            json={"clientKey": api_key, "taskId": task_id},
            timeout=15,
        ).json()
        if result.get("errorId") != 0:
            raise RuntimeError(result.get("errorCode", "task_failed"))
        if result.get("status") == "ready":
            return result["solution"]
        if result.get("status") not in {"idle", "processing"}:
            raise RuntimeError("unexpected_task_status")

    raise TimeoutError("verification_task_deadline_exceeded")
El llamador debe permitir solo un intento limitado por defecto. La solución devuelta debe aplicarse a través del camino de integración documentado en el mismo contexto de navegador que detectó el punto de verificación. Si la página no transiciona al estado esperado, devuelva un error o solicite revisión humana.
Redime tu código de bonificación de CapSolver
¡Aumenta tu presupuesto de automatización instantáneamente!
Usa el código de bonificación CAP26 al recargar tu cuenta de CapSolver para obtener un 5% adicional en cada recarga — sin límites.
Redímelo ahora en tu Panel de CapSolver
Una vez confirmada la página como contenido, elimina el ruido de navegación, scripts, elementos ocultos, banners repetidos y otros elementos de la página. Preserva encabezados, etiquetas, tablas y referencias de origen. No envíes cookies del navegador, encabezados de autorización, datos personales o trazas de sesión sin procesar al modelo.
import json
import os
import requests

ZAI_ENDPOINT = "https://api.z.ai/api/paas/v4/chat/completions"

def extract_with_glm(job: ExtractionJob, normalized_text: str) -> dict:
    prompt = {
        "source_url": job.source_url,
        "required_fields": list(job.required_fields),
        "rules": [
            "Devuelve un objeto JSON y nada más.",
            "Usa solo evidencia presente en page_text.",
            "No infieras un valor requerido faltante.",
            "Incluye source_url exactamente como se proporciona.",
        ],
        "page_text": normalized_text[: job.max_input_chars],
    }
    response = requests.post(
        ZAI_ENDPOINT,
        headers={
            "Authorization": f"Bearer {os.environ['ZAI_API_KEY']}",
            "Content-Type": "application/json",
        },
        json={
            "model": os.getenv("GLM_MODEL", "glm-5.3-flash"),
            "messages": [
                {"role": "system", "content": "Extrae datos estructurados respaldados por evidencia."},
                {"role": "user", "content": json.dumps(prompt, ensure_ascii=False)},
            ],
            "temperature": 0,
        },
        timeout=60,
    )
    response.raise_for_status()
    content = response.json()["choices"][0]["message"]["content"]
    return json.loads(content)
Trátalo como un límite de adaptador. Confirma las opciones de solicitud y las funciones de salida estructurada en la documentación oficial de Z.ai antes del uso en producción. Si el modelo envuelve JSON en Markdown o devuelve texto fuera del contrato, rechace la respuesta en lugar de intentar repararla en silencio.
Se requieren dos validaciones diferentes.
Primero, valida el resultado del navegador. Confirma que la URL final, el encabezado esperado, el contenedor objetivo y la ausencia de un nuevo error coincidan con el flujo deseado. Una respuesta exitosa no es prueba de que la página continúe.
Segundo, valida el registro extraído. Verifica cadenas requeridas, rangos numéricos, fechas, URLs normalizadas, claves duplicadas y fragmentos de evidencia. Para campos de alto impacto, compara el valor con un selector determinista o una segunda representación independiente de la página.
def run_extraction(job: ExtractionJob, state: PageState, page_text: str) -> dict:
    action = choose_action(state)
    if action != "extract":
        raise RuntimeError(f"page_not_ready_for_model:{action}")
    candidate = extract_with_glm(job, page_text)
    return validate_record(job, candidate)
Este último filtro evita que una página de desafío, alucinación del modelo o renderizado parcial entre en el conjunto de datos como un scraping exitoso.
Registra un ID de seguimiento, URL de origen, URL final, estado de página, hash del contenido, nombre del modelo, versión del prompt, versión del esquema, resultado de validación y tiempo de procesamiento. Almacena IDs de tarea y códigos de error para depuración operativo de corta duración, pero no almacenes tokens de solución, secretos o datos de sesión no relacionados.
Aplica un presupuesto único para todo el trabajo. Cuenta intentos HTTP, navegaciones del navegador, intentos de verificación, llamadas a GLM, caracteres de entrada y tiempo transcurrido. Cuando el presupuesto se agote, devuelve un error tipado en lugar de permitir que un componente reinicie el flujo.
Un conjunto útil de métricas incluye:
| Síntoma | Causa probable | Acción correcta |
|---|---|---|
| GLM devuelve detalles sobre una página de verificación | La respuesta no fue clasificada antes de invocar | Detén la llamada al modelo y corrige la detección de estado de página |
| JSON se analiza pero los campos requeridos están vacíos | El prompt o la evidencia de origen es incompleta | Rechaza el registro e inspecciona el contenido normalizado |
| La tarea está lista pero la página sigue bloqueada | El contexto del navegador o los parámetros de tarea no coinciden | Compara URL, sesión, agente de usuario, tiempo y requisitos documentados |
| El costo aumenta mientras los registros aceptados permanecen planos | La escalación del navegador o modelo es demasiado amplia | Agrega filtros deterministas y presupuestos por trabajo |
| Filas duplicadas aparecen después de reintentos | El almacenamiento no es idempotente | Inserta o actualiza por clave de origen estable y versión de contenido |
| El HTTP 429 se repite | La concurrencia se controla por trabajador, no globalmente | Introduce un presupuesto de tasa compartido y respeta la guía de reintentos |
GLM-5.3 puede hacer que la extracción de datos web sea más flexible, pero la confiabilidad proviene del sistema circundante. Mantén el control de acceso, renderizado, clasificación de estado de página, manejo de verificación, validación de esquema y almacenamiento como etapas explícitas. Usa el modelo solo después de que la aplicación haya confirmado que está viendo el contenido deseado.
Para un flujo de navegador autorizado con una tarea de verificación respaldada, CapSolver puede proporcionar el límite de tarea documentado. La aplicación sigue siendo responsable de los permisos, la continuidad de la sesión, los reintentos limitados, el manejo de secretos y la prueba de que el flujo original se completó.
P: ¿Puede GLM-5.3 reemplazar un navegador en el scraping de web?
No. Puede interpretar texto, capturas de pantalla o registros normalizados, pero un navegador o cliente HTTP sigue siendo el responsable de la navegación, renderizado, estado, permisos y verificación del resultado final.
P: ¿Debería enviarse HTML sin procesar directamente a GLM-5.3?
Normalmente no. Clasifique primero la respuesta, elimine scripts y ruido de diseño repetido, preservar etiquetas y estructura significativas, y limite la entrada a los datos necesarios por el esquema de extracción.
P: ¿Cuándo debe llamar el flujo de trabajo a CapSolver?
Solo después de detectar una tarea compatible en un flujo de trabajo permitido. Use el tipo de tarea documentado actual, preservar el contexto del navegador requerido, establezca un plazo y verifique que la página realmente continuó.
P: ¿Significa que un JSON válido que el registro extraído es correcto?
No. La sintaxis JSON no demuestra precisión factual. Los campos obligatorios, tipos, URLs, fechas, rangos numéricos, duplicados y evidencia de origen deben verificarse en código.
P: ¿Qué debe hacerse cuando el estado de la página es desconocido?
Deténgase y solicite una revisión. No envíe contenido desconocido al modelo o intente nuevamente a través de pasos adicionales de navegador y verificación.
P: ¿Puede este diseño usarse para datos privados o restringidos?
El diseño no crea permisos. Úselo solo para datos públicos u otros datos autorizados, minimice la información recopilada y siga los términos, contratos y leyes aplicables.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Comprenda el soporte de proxy MCP para CAPTCHA a través de la conexión del cliente, el navegador y la tarea de resolución, incluyendo los límites de las herramientas MCP de CapSolver actuales.
Entienda el manejo de CAPTCHA de Stagehand, compare las acciones del navegador con los servicios de resolución y elija un enfoque claro para navegadores locales o sesiones alojadas.