
🎉NUEVOCapSolver para agentes de IA-Integraciones de MCP, herramientas de agente y SDK
Aloísio Vítor
Image Processing Expert
Publicado Apr 24, 2025
Actualizado Sep 23, 2026 · min de lectura
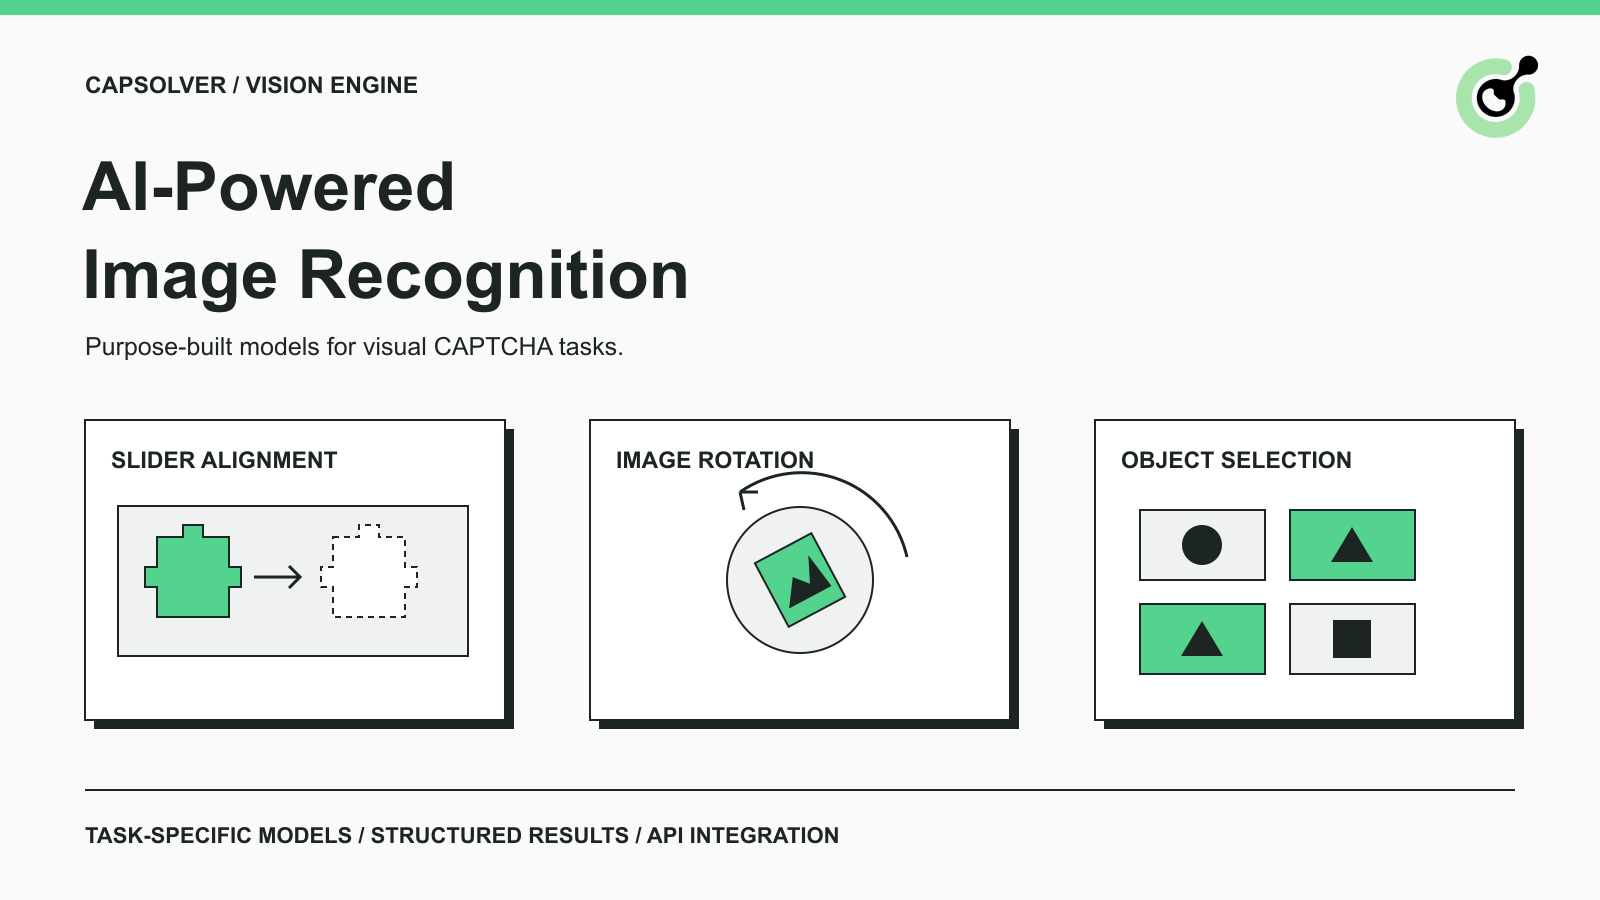
Los CAPTCHA basados en imágenes ahora son uno de los mayores obstáculos en la automatización del navegador, la resolución de CAPTCHA con IA y el scraping de web. Según un informe de Web Data Lab de 2024, el 61% de los proyectos de automatización menciona los CAPTCHA basados en imágenes como su principal fuente de fallas, más que las prohibiciones de IP o problemas de scripting.
Muchas plataformas de comercio electrónico grandes y otras han adoptado deslizadores complejos, rotaciones y acertijos visuales que no se pueden resolver con OCR básico o modelos generales de análisis de imágenes con IA. Estas defensas requieren más que solucionadores tradicionales: demandan sistemas de reconocimiento de imágenes basados en aprendizaje automático y específicos para tareas, capaces de adaptarse a la complejidad del mundo real.
Por eso construimos Vision Engine, el solucionador de CAPTCHA de IA avanzado de CapSolver, que ofrece altas tasas de éxito, respuestas rápidas y personalización completa para escenarios de automatización desafiantes.
En los últimos años, el reconocimiento de imágenes basado en IA ha avanzado significativamente en tareas como detección de objetos, clasificación de imágenes y segmentación de múltiples objetos. Las arquitecturas CNN tradicionales funcionan bien en datos estructurados, mientras que los modelos basados en transformadores ofrecen una generalización y comprensión contextual sólida. Sin embargo, cuando se trata de resolver desafíos complejos y diversos de CAPTCHA basados en imágenes, es esencial un enfoque híbrido: uno que combine procesamiento de imágenes clásico, modelos de aprendizaje profundo y razonamiento mediante modelos de lenguaje grandes (LLM).
Vision Engine de CapSolver se basa en este principio exacto. En el núcleo de Vision Engine de CapSolver hay un modelo de IA potente, entrenado específicamente para resolver desafíos modernos de CAPTCHA basados en imágenes. A diferencia de OCR genérico o modelos de visión, Vision Engine está optimizado para alta precisión, rendimiento en tiempo real y adaptabilidad a una amplia gama de tareas de verificación visual.
¡Obtén tu Código de Bono para soluciones de CAPTCHA top -CapSolver: VISION. Después de canjearlo, obtendrás un bono adicional del 5% después de cada recarga, ilimitado
Nos especializamos en soluciones altamente personalizables. Basado en la complejidad, la frecuencia de actualización y la urgencia de la tarea, entregamos un modelo inicial en 1-5 días hábiles. Aunque la primera versión puede no ser perfecta, es rápida, eficiente y admite respuestas en tiempo real. Al mismo tiempo, recopilamos automáticamente muestras resueltas/no resueltas y activamos entrenamiento mejorado una vez que se recopila suficiente data. Después de 1-3 ciclos de actualización, los modelos suelen alcanzar más del 90% de precisión. (Consulte los tipos de imágenes compatibles a continuación para más detalles.)
Con Vision Engine, CapSolver ofrece más que solo reconocimiento de IA: es una solución rápida y escalable diseñada para evolucionar con sus necesidades y mantenerlo a la vanguardia de las defensas de CAPTCHA modernas.
Para abordar la creciente complejidad de los sistemas de CAPTCHA basados en imágenes, Vision Engine ha sido entrenado para manejar una amplia gama de formatos visuales utilizados en aplicaciones web modernas. Su fortaleza radica en una amplia adaptabilidad: soporta múltiples tipos de imágenes adaptados a diferentes escenarios de interacción.
slider_1 – CAPTCHA de rompecabezas de deslizamiento estándar
rotate_1 – Desafíos de rotación que requieren alinear imágenes inclinadas.
shein- Desafíos de CAPTCHA con estilo de la página web SHEIN. Normalmente tareas basadas en imágenes como hacer clic en artículos de moda específicos (por ejemplo, bolsos o zapatos). Se centra en el reconocimiento visual dentro de imágenes relacionadas con la moda
space_detection – Acertijos de razonamiento espacial que requieren detectar posiciones de objetos.
slider_temu_plus – Deslizadores personalizados con mayor complejidad y variaciones de estilo.
select_temu – Tareas de selección de objetos de múltiples opciones de imagen, simulando clics de usuarios.👉 Para conocer los formatos de tarea completos y ejemplos de solicitud, consulte nuestra documentación
Para satisfacer la creciente demanda de diversos CAPTCHA basados en imágenes, Vision Engine de CapSolver utiliza múltiples arquitecturas de modelo especializadas. Estos modelos permiten soluciones rápidas y escalables, asegurando un alto nivel de precisión y rendimiento en diversos escenarios.
Arquitecturas de modelos personalizados: Con más de 5 arquitecturas de modelo ya en uso, garantizamos que Vision Engine sea adaptable a una amplia gama de tipos de CAPTCHA.
Entrenamiento eficiente y recolección de datos: Implementamos un enfoque semiautomático, totalmente automático o híbrido según las necesidades del usuario, el volumen de tráfico y la frecuencia de actualización del sitio, asegurando una recolección rápida de datos, mejora del modelo y actualizaciones continuas.
Soluciones rápidas y completas: Nuestro enfoque minimiza el costo de comunicación del usuario al ofrecer soluciones rápidas y personalizadas, entregando modelos para pruebas en 1-5 días hábiles, dependiendo de la complejidad de la tarea.
Vision Engine de CapSolver admite tres categorías principales de desafíos de CAPTCHA basados en imágenes, cada una requiriendo enfoques diferentes para el desarrollo y la personalización del modelo:
| Categoría | Tipos de tarea incluidos | Descripción | Tiempo de desarrollo | Precisión del modelo | Velocidad del modelo |
|---|---|---|---|---|---|
| 1. Imagen de alta precisión individual | slider_1, rotate_1 |
Requieren una alineación o posicionamiento altamente preciso para un elemento de imagen único. | 1–3 días hábiles | > 95% | 0–200 ms |
| 2. Contenido variable, tipo fijo | space_detection, shein |
El formato de imagen permanece consistente, pero el contenido (objetos, texto o objetivos visuales) varía según el desafío. | 3–5 días hábiles | > 80% | 200–600 ms |
| 3. Contenido y tipo variable | slider_temu_plus, select_temu |
Los formatos y el contenido de las tareas varían. A menudo involucran múltiples respuestas posibles o selecciones de imágenes. | 3–5 días hábiles (confirmados) | > 80% | 200–1000 ms (depende) |
Con Vision Engine de CapSolver, obtiene más que solo una solución confiable. Nuestra tecnología se adapta a sus necesidades, mejorando con cada interacción, asegurando la solución más eficiente y precisa para resolver CAPTCHA.
Vision Engine de CapSolver está diseñado para integrarse sin problemas con sus flujos de trabajo de scraping y automatización del navegador. Con soporte robusto de API, los desarrolladores pueden automatizar fácilmente tareas de resolución de CAPTCHA y integrar fácilmente Vision Engine en diversos proyectos. Ya sea que esté trabajando con Python, JavaScript u otros lenguajes, el proceso de integración permanece sencillo y eficiente.
El ejemplo oficial de Vision Engine en Python utiliza slider_1 para reconocer un rompecabezas de deslizador. Necesita Python, el paquete capsolver, una clave de API y imágenes de deslizador y fondo de un desafío autorizado.
Instale el paquete con pip install --upgrade capsolver. El siguiente es el ejemplo oficial con sus marcadores de posición originales; reemplácelos antes de ejecutarlo:
# pip install --upgrade capsolver
# export CAPSOLVER_API_KEY='...'

import capsolver

capsolver.api_key = "..."

solution = capsolver.solve({
    "type": "VisionEngine",
    "module": "slider_1",
    "image": "/9j/4AAQSkZJRgABA......",
    "imageBackground": "/9j/4AAQSkZJRgABA......"
})
print(solution)
Reemplace capsolver.api_key con su clave, image con el contenido completo en Base64 de la imagen del deslizador y imageBackground con el fondo correspondiente. Las cadenas de imagen abreviadas anteriores no son imágenes utilizables. Elimine los saltos de línea y cualquier prefijo de datos-URL de sus valores en Base64. Guarde el ejemplo completado como vision_slider.py y ejecute python vision_slider.py.
Para slider_1, el resultado documentado contiene distance, la distancia del deslizador calculada a partir de las imágenes enviadas. El ejemplo de API muestra solution.distance como 213; este es un valor ilustrativo, no un ajuste fijo para cada rompecabezas.
Vision Engine devuelve datos de reconocimiento. Su automatización del navegador debe realizar la interacción correspondiente y verificar si la página lo acepta. Para llamadas directas a la API, createTask devuelve el resultado de reconocimiento sin un paso separado de getTaskResult para consultar.
Vision Engine destaca por su capacidad para entregar rápidamente modelos de reconocimiento de imágenes personalizados para desafíos visuales únicos. Ya sea que esté lidiando con CAPTCHA de comercio electrónico complejos o formatos especializados, nuestro equipo puede tomar sus requisitos y implementar una API funcional en tan solo 3–7 días.
En un caso reciente, entregamos un modelo de CAPTCHA de deslizamiento listo para producción para una gran plataforma de retail en 3 días, logrando alta precisión y estabilidad.
Para garantizar una integración fluida, CapSolver ofrece:
Así es como llevamos su modelo personalizado en línea — rápidamente:
graph TD
  A[Presentación de Requisitos] --> B[Evaluación del Modelo]
  B --> C[Preparación del Conjunto de Datos]
  C --> D[Entrenamiento del Modelo]
  D --> E[Implementación de API]
  E --> F[Soporte de Integración]

  classDef stage fill:#e0f7fa,stroke:#00acc1,stroke-width:2px;
class A,B,C,D,E,F stage;CapSolver's Vision Engine no es solo una herramienta: es una solución inteligente y en evolución para desarrolladores que enfrentan desafíos de automatización del mundo real. Ya sea que esté resolviendo deslizadores o acertijos espaciales, nuestro motor de IA se vuelve más fuerte con cada tarea, ofreciendo precisión, escalabilidad y amigabilidad para desarrolladores sin precedentes.
P1: ¿Cómo se utiliza la IA en el reconocimiento de imágenes?
La IA utiliza aprendizaje profundo (especialmente redes neuronales convolucionales) para analizar imágenes al reconocer patrones, formas y contextos semánticos. En escenarios de CAPTCHA, los modelos de IA se entrenan para entender texto, disposición, ubicación de objetos y posicionamiento lógico en acertijos visuales complejos.
P2: ¿Puede la IA resolver CAPTCHA basados en imágenes?
Sí. La IA ahora puede resolver una amplia gama de CAPTCHA basados en imágenes, desde rompecabezas de deslizadores hasta preguntas visuales de varios pasos. Vision Engine está entrenado en grandes conjuntos de datos para manejarlos con alta precisión.
P3: ¿Puedo solicitar un modelo personalizado?
Absolutamente. CapSolver puede entregar soluciones de reconocimiento de imágenes personalizadas. Desde la solicitud hasta la implementación, puede tomar solo unos días dependiendo de la complejidad y la disponibilidad del conjunto de datos.
Aloísio Vítor
Image Processing Expert
Interpreting the visual signals behind web workflows.
SOBRE EL AUTOR
Conectar CapSolver MCP a rtrvr con nombres de herramientas calificados, manejo del modo token, límites de sesión, orquestación probada y verificaciones del estado final.
Gestionar CAPTCHAs no resueltos en flujos de trabajo de agentes de IA con límites claros de reintentos, transferencias útiles a humanos, control de la propiedad del navegador y reanudación de tareas verificada.
Aprende cómo los agentes de IA detectan CAPTCHAs con el CapSolver Core SDK, ejecuta un ejemplo de Python probado y separa la detección de la resolución y la finalización del flujo de trabajo.
Comparar el uso del navegador, el manejo de CAPTCHA en navegadores locales y en la nube, aprender dónde se adapta CapSolver y elegir una configuración práctica para flujos de trabajo de agentes autorizados.
