
Como encontrar elementos por XPath no Selenium
Resposta
No Selenium, elementos podem ser localizados usando XPath via findElement(By.xpath()) para uma única correspondência ou findElements(By.xpath()) para múltiplas correspondências. O XPath permite navegar pela estrutura DOM usando caminhos, atributos e condições para identificar elementos mesmo quando IDs ou classes são dinâmicos ou ausentes.
Explicação Detalhada
XPath (Linguagem de Caminho XML) é uma sintaxe de consulta usada para percorrer e localizar nós em um documento HTML ou XML. Como as páginas da web são estruturadas como uma árvore DOM, o Selenium utiliza expressões XPath para buscar dentro dessa hierarquia. Internamente, o WebDriver envia instruções de localização para o navegador, que avalia o DOM e retorna os nós correspondentes. Isso torna o XPath especialmente útil para páginas dinâmicas onde seletores estáticos como IDs ou nomes de classes são confiáveis.
Existem dois principais modos de avaliação: XPath absoluto (caminho completo desde a raiz) e XPath relativo (começando de qualquer nó). O XPath relativo é preferido porque é mais estável e menos sensível às mudanças na interface do usuário. O Selenium executa o localizador no contexto atual e retorna o primeiro elemento correspondente ou uma lista de todos os elementos correspondentes, dependendo do método usado. Esses comportamentos são consistentes com os mecanismos padrão de pesquisa de elementos do WebDriver.
Soluções / Métodos
- Use findElement com XPath: Recupere o primeiro elemento correspondente usando uma expressão XPath precisa como
//input[@name='email']. - Use findElements para extração em massa: Ao raspar listas ou componentes repetidos, retorne todos os elementos correspondentes e itere por eles de forma segura.
- Use XPath relativo robusto + suporte à automação: Prefira expressões com contains(), starts-with() ou filtros de atributos. Em páginas protegidas ou altamente dinâmicas, frameworks de automação combinados com soluções de resolução de captchas, como CapSolver, podem ajudar a manter a continuidade da raspagem quando desafios de acesso ocorrerem.
Boas Práticas / Dicas
Evite XPath absoluto sempre que possível, pois ele quebra facilmente quando a estrutura da página muda. Em vez disso, projete localizadores com base em atributos estáveis como campos data-* ou papéis semânticos. Além disso, sempre combine o uso de XPath com esperas explícitas para lidar com renderização assíncrona e prevenir erros NoSuchElementException em aplicações dinâmicas.
👉 Relacionado:
- Como resolver Recaptcha no web scraping usando Python
- Resolver Captcha no web scraping usando Python
- Como integrar o Selenium
- Web scraping com Selenium e Python
Use o código
FAQao se cadastrar no CapSolver para receber um bônus adicional de 5% em seu recarregamento.
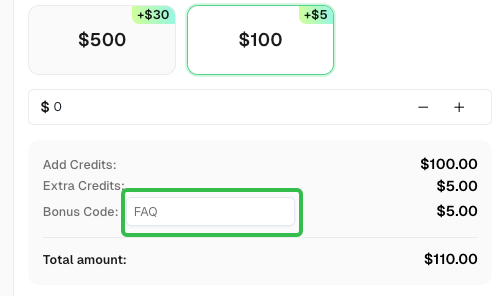
FAQ da CapSolver - capsolver.com