ImageToTextTask vs VisionEngine: Pilih Pemecah CAPTCHA Gambar

Lucas Mitchell
Automation Engineer
TL;DR
- Pilih tugas CAPTCHA gambar berdasarkan input dan output yang telah didokumentasikan, bukan hanya karena tantangan mengandung gambar.
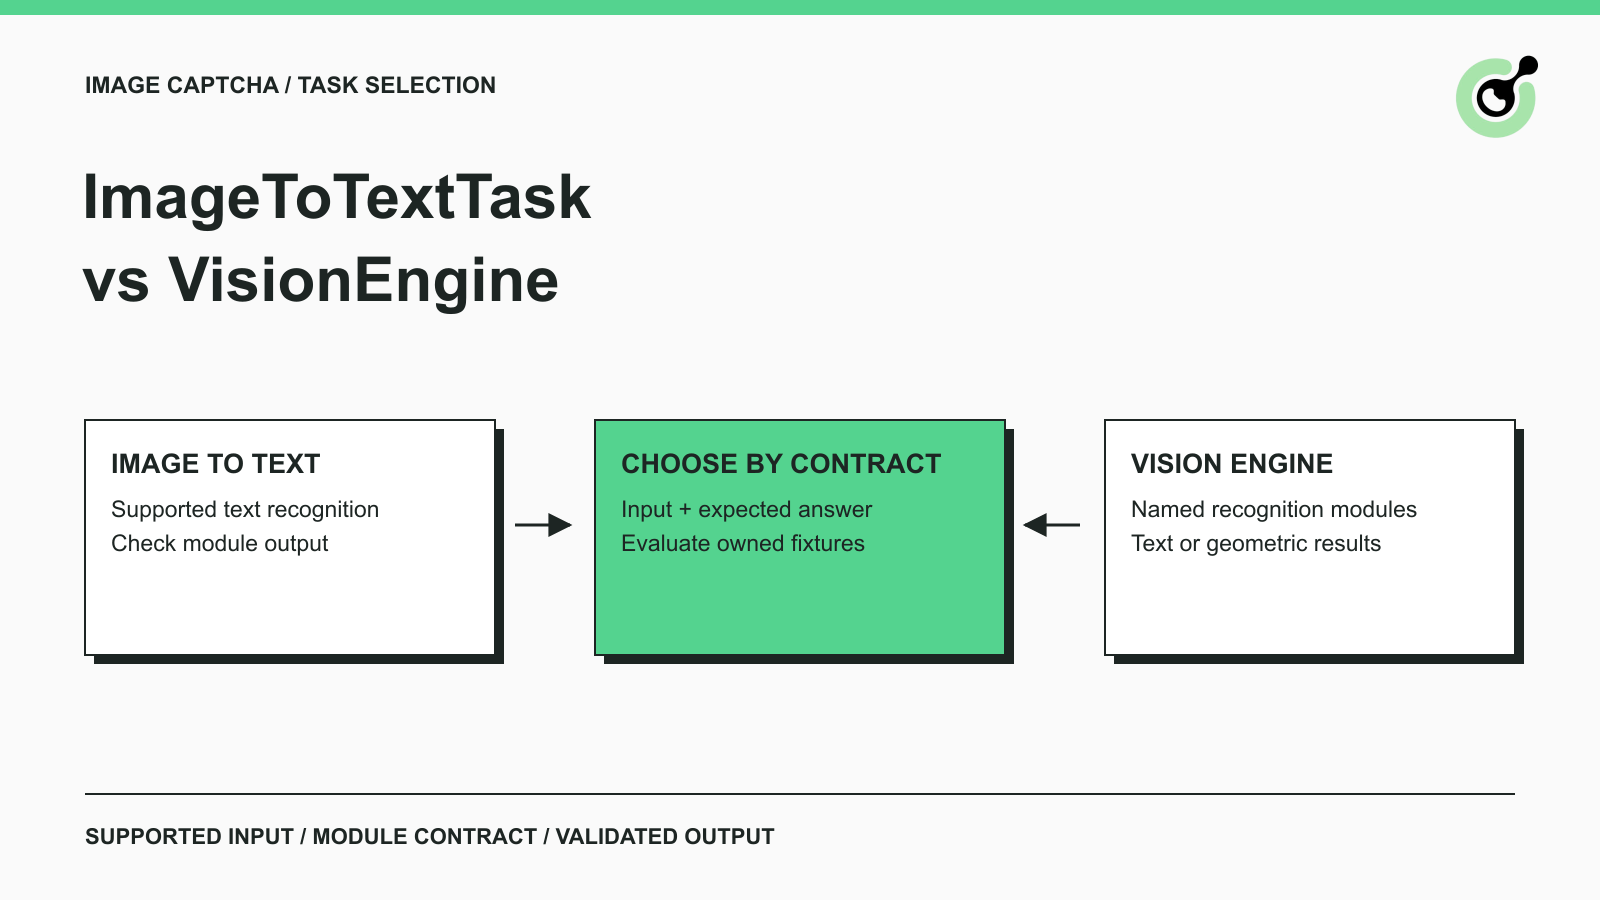
- ImageToTextTask adalah titik awal untuk pengenalan teks yang didukung; VisionEngine menyediakan modul bernama dengan bentuk hasil yang berbeda.
- VisionEngine tidak hanya geometris: contoh
ocr_gifyang didokumentasikan mengembalikan teks. - Kedua keluarga tugas mengembalikan hasil pengenalan langsung dari
createTask; jangan menambahkan langkah polling secara default. - Validasi pengenalan secara terpisah dari penggunaan jawaban dalam aplikasi, terutama ketika melibatkan koordinat, dimensi gambar, atau tantangan yang diperbarui.
Apa perbedaan antara ImageToTextTask dan VisionEngine?
ImageToTextTask dan VisionEngine adalah keluarga tugas pengenalan gambar dengan bidang permintaan dan respons yang berbeda. Pemilihan yang benar bergantung pada format tantangan yang didukung oleh aplikasi yang sah dan jawaban yang dibutuhkan aplikasi berikutnya.
Di CapSolver, memilih keluarga yang benar berarti lebih dari sekadar mengganti nama tugas. Parser yang mengharapkan karakter yang dikenali tidak dapat secara aman mengonsumsi jarak atau sudut. Sebaliknya, jawaban geometris tidak diperlukan ketika langkah berikutnya aplikasi hanya membandingkan string yang dikenali dengan fixture yang diketahui.
Optical character recognition, atau OCR, mengekstrak teks dari gambar. Hal ini membantu menjelaskan satu kategori pengenalan CAPTCHA, tetapi "CAPTCHA gambar" lebih luas daripada OCR. Tantangan dapat meminta teks, posisi, atau hubungan visual lainnya.
Panduan ini membandingkan kontrak yang telah didokumentasikan dan pilihan evaluasi. Skenario yang dibahas melibatkan fixture CAPTCHA yang dikelola dan QA yang diizinkan. Panduan ini tidak menyajikan skrip umum untuk berinteraksi dengan situs web arbitrer atau mengklaim bahwa hasil pengenalan menyelesaikan tantangan browser sendirian.
Bandingkan kontrak tugas sebelum memilih
Kontrak tugas menentukan data gambar yang Anda kirim dan cara Anda menginterpretasikan hasilnya.
| Perbandingan | ImageToTextTask | VisionEngine |
|---|---|---|
| Bidang gambar permintaan utama | body |
image |
| Pemilihan tugas | ImageToTextTask, dengan opsi modul yang telah didokumentasikan |
VisionEngine ditambah modul bernama yang didukung |
| Hasil yang diharapkan | Teks atau jawaban khusus modul | Hasil teks atau geometris khusus modul |
| Pengiriman hasil | Respons langsung dari createTask | Respons langsung dari createTask |
| Pertanyaan integrasi utama | Apakah mode pengenalan yang dipilih sesuai dengan jawaban yang diharapkan? | Apakah modul yang tepat sesuai dengan format gambar dan kontrak output? |
| Asumsi yang tidak aman | Setiap respons adalah satu string teks | Setiap gambar dapat menggunakan modul atau parser yang sama |
Referensi ImageToTextTask mendokumentasikan konten gambar Base64 dalam body, tanpa baris baru atau awalan data-URI. Contoh-contohnya membedakan text dari answers yang khusus pada modul. Baca respons modul yang dipilih alih-alih menyederhanakan setiap hasil sukses menjadi satu string.
Referensi VisionEngine mendokumentasikan modul bernama: contohnya slider_1 mengembalikan distance, modul rotasi mengembalikan angle, dan botdeflector mengembalikan points. Contoh ocr_gif mengembalikan text. Tabel properti umum menyebutkan imageBackground sebagai wajib, sementara beberapa contoh modul mengabaikannya. Selesaikan perbedaan ini berdasarkan contoh modul yang tepat dan konfirmasikan ambiguitas yang tersisa sebelum implementasi.
Contoh-contoh ini menetapkan kontrak yang didukung, bukan pemahaman gambar umum. Nama tugas bukanlah izin untuk membuat modul, menambahkan prompt bebas, atau mengharapkan tipe respons yang tidak didokumentasikan oleh modul yang dipilih.
Kapan Anda harus memulai dengan ImageToTextTask?
Mulailah dengan ImageToTextTask ketika jawaban yang berguna dari tantangan yang didukung adalah teks yang dikenali dan modul yang telah didokumentasikan sesuai dengan input Anda.
Misalnya, tim Anda memelihara formulir kontak lama dan memiliki kumpulan uji karakter yang diizinkan. Pertanyaan evaluasi spesifik: apakah jalur pengenalan dapat mengembalikan karakter yang diharapkan oleh fixture? Anda dapat membandingkan string yang dikembalikan dengan label uji tanpa melibatkan koordinat browser atau gerakan pointer.
Tentukan aturan teks aplikasi sebelum mengevaluasi solver. Apakah formulir Anda membedakan huruf besar dan kecil? Apakah mempertahankan nol di depan? Apakah menerima spasi? Ini adalah properti aplikasi yang Anda kendalikan. Mereka seharusnya tidak secara diam-diam diubah oleh fungsi pembersihan hasil yang umum.
Sebagai contoh, fixture yang diberi label "007A" harus tetap menjadi string selama perbandingan. Menangani hasilnya sebagai angka akan membuat parser aplikasi bertanggung jawab atas kesalahan yang bisa dihindari. Ini adalah contoh validasi ilustratif, bukan hasil solver yang dilaporkan.
Jaga hasil kosong dan bentuk respons yang salah terpisah. Kehilangan bidang yang diharapkan adalah masalah integrasi yang perlu diperiksa. Jawaban yang berbentuk benar tetapi salah termasuk dalam evaluasi pengenalan. Menggabungkan keduanya menjadi satu angka "akurasi" menyembunyikan apakah pemilihan tugas atau pengenalan gambar yang perlu diperhatikan.
Kapan VisionEngine pantas dievaluasi?
Evaluasi VisionEngine ketika modul yang telah didokumentasikan sesuai dengan format tantangan dan struktur yang dikembalikan adalah informasi yang dibutuhkan aplikasi Anda.
Untuk uji gambar yang dikelola, sudut dan daftar titik mewakili asersi yang berbeda. Sudut dapat dibandingkan dengan orientasi yang diharapkan oleh fixture. Daftar titik memerlukan aturan interpretasi sendiri. Keduanya tidak boleh melewati pemroses yang ditulis untuk pengenalan karakter.
Siapkan adapter khusus modul dengan tanggung jawab yang sengaja sempit: terima bentuk hasil yang telah didokumentasikan, validasi, dan serahkan jawaban yang diinterpretasikan ke aplikasi yang dikelola. Jangan biarkan adapter tersebut memutuskan kontrol browser yang tidak terkait. Memisahkan interpretasi pengenalan membuat kegagalan lebih mudah direproduksi dengan fixture yang disimpan.
Kehadiran modul OCR juga mencegah aturan sederhana seperti "teks selalu berarti ImageToTextTask." Untuk input teks animasi, periksa format dan modul yang didokumentasikan sebelum memilih. Hanya format jawaban saja tidak menetapkan bahwa dua tugas menerima input yang sama atau melakukan dengan baik pada mereka.
Jika tidak ada modul yang didokumentasikan yang sesuai dengan tantangan, catat sebagai tidak didukung atau tidak terselesaikan. Mengubah label permintaan hingga API menerima payload bukan metode evaluasi yang andal. Penerimaan permintaan tidak menetapkan bahwa model pengenalan sesuai dengan gambar.
Klaim Kode Bonus CapSolver Anda
Meningkatkan anggaran otomasi Anda secara instan!
Gunakan kode bonus CAP26 saat menambahkan dana akun CapSolver Anda untuk mendapatkan tambahan 5% bonus pada setiap penyetoran — tanpa batas.
Klaim sekarang di Dashboard CapSolver Anda

Bagaimana persiapan gambar memengaruhi perbandingan?
Persiapan gambar harus mempertahankan bukti yang dibutuhkan oleh setiap tugas yang mungkin, sehingga evaluasi mengukur kesesuaian tugas alih-alih perbedaan pra-pemrosesan yang tidak sengaja.
Base64 adalah representasi byte. Spesifikasi Base64 RFC 4648 mendefinisikan enkoding ini; itu tidak menetapkan bahwa file yang dienkripsi adalah gambar yang benar untuk modul pengenalan. Payload dapat secara sintaksis dienkripsi dan masih berisi tantangan lama, potongan yang salah, atau format gambar yang tidak didukung.
Untuk setiap fixture yang dikelola, pertahankan referensi ke gambar asli dan catat transformasi apa pun sebelum pengiriman. Contohnya termasuk mengubah ukuran, menyederhanakan animasi, atau mengganti potongan. Hindari menerapkan transformasi yang sama secara diam-diam ke setiap keluarga tugas: menghapus frame animasi dapat mengubah informasi yang tersedia untuk tugas yang ditujukan untuk input animasi.
Jika modul yang dievaluasi membutuhkan gambar latar depan dan belakang, pastikan keduanya berasal dari instance fixture yang sama. Menggabungkan latar depan dari satu refresh dengan latar belakang dari yang lain menciptakan ketidakcocokan input. Kegagalan ini tidak boleh dihitung sebagai bukti bahwa modul yang valid tidak akurat.
Gunakan gambar uji sintetis atau yang disetujui tanpa informasi pribadi yang tidak relevan. Screenshot halaman dukungan utuh mungkin berisi lebih dari tantangan. Membatasi gambar yang dikirim hanya pada input yang diizinkan membuat uji lebih jelas dan mengurangi paparan data yang tidak perlu.
Mengapa hasil koordinat lebih sulit diintegrasikan daripada teks?
Hasil koordinat memerlukan kesepahaman tentang referensi gambar dan kerangka tata letak sebelum aplikasi dapat menggunakannya secara benar.
Titik yang diukur terhadap gambar asli bukanlah titik otomatis di viewport browser. Definisi persegi panjang batas browser menggambarkan persegi panjang relatif terhadap viewport dan mencakup border dan padding elemen. Ini berbeda dari asumsi bahwa elemen yang ditampilkan tepat sesuai dengan dimensi gambar mentah.
Dalam harness QA yang dikelola, uji interpretasi koordinat sebagai komponen terpisah. Catat dimensi fixture, dimensi yang sebenarnya ditampilkan ke solver, dan representasi aplikasi yang digunakan untuk mengevaluasi jawaban. Jika representasi ini berbeda, aplikasi perlu memiliki pemetaan yang jelas dan teruji sesuai dengan antarmuka sendiri.
Jangan gunakan respons pengenalan yang berhasil sebagai bukti bahwa pemetaan tersebut benar. Uji yang berguna dapat membandingkan hasil yang diinterpretasikan dengan fixture yang diberi label sebelum ada tindakan browser. Uji kedua dapat memverifikasi bahwa komponen yang dikelola mengonsumsi hasil yang diinterpretasikan sesuai yang diharapkan.
Pemisahan ini juga membantu dengan tantangan yang diperbarui. Jika UI mengganti gambar saat pengenalan sedang berlangsung, jawaban tetap milik fixture asli. Aplikasi Anda harus menghapus asosiasi lama tersebut alih-alih menerapkan hasil ke gambar pengganti.
Bagaimana Anda dapat membandingkan akurasi dan biaya operasional secara adil?
Perbandingan yang adil mengelompokkan hasil berdasarkan keluarga tantangan yang didukung dan menghitung hasil aplikasi yang selesai secara terpisah dari respons API yang valid.
Mulailah dengan kumpulan fixture yang representatif dan berwenang. Sertakan variasi gambar yang dihasilkan aplikasi Anda, seperti dimensi normal dan rentang karakter yang diharapkan. Pertahankan set uji yang diberi label untuk evaluasi sehingga penyesuaian pra-pemrosesan tidak dinilai hanya pada contoh yang sama yang memotivasi mereka.
Catat kategori ini secara terpisah:
| Kategori evaluasi | Apa yang memberi tahu Anda |
|---|---|
| Input ditolak | Permintaan atau format perlu perhatian |
| Bentuk respons yang diharapkan dikembalikan | Kontrak pemroses terpenuhi |
| Jawaban sesuai fixture | Pengenalan memenuhi kriteria fixture |
| Aplikasi yang dikelola menerima jawaban | Integrasi mempertahankan makna jawaban yang dimaksudkan |
| Hasil tiba setelah penggantian fixture | Waktu atau siklus hidup membuat jawaban tidak berguna |
Jangan membandingkan tugas yang tidak terkait menggunakan satu skor akurasi utama. Fixture teks dan fixture geometris menguji output yang berbeda. Di mana dua opsi yang telah didokumentasikan benar-benar sesuai dengan keluarga input yang sama, pertahankan set fixture dan definisi keberhasilan yang sama.
Untuk biaya, ukur pengeluaran total terhadap hasil yang berhasil dan relevan serta akuntansi pekerjaan teknik. Parser yang memerlukan investigasi manual sering kali memakan waktu meskipun biaya tugasnya kecil. Tidak ada pemenang universal dalam harga atau kinerja yang ditetapkan hanya oleh nama field API.
Ini adalah rekomendasi evaluasi, bukan hasil benchmark. Jalankan mereka terhadap aplikasi yang Anda izinkan sebelum membuat klaim tentang akurasi, kecepatan, atau penghematan.
Checklist pemilihan tugas akhir harus mencakup apa?
Checklist pemilihan tugas harus mengidentifikasi input yang didukung, jawaban yang diharapkan, perilaku pengiriman, dan uji penerimaan aplikasi.
Untuk setiap keluarga CAPTCHA yang didukung, dokumentasikan tugas dan modul yang dipilih, aturan persiapan gambar, bidang solusi yang diharapkan, dan apa yang terjadi jika respons memiliki bentuk lain. Tetapkan pemilik untuk meninjau asumsi tersebut ketika aplikasi Anda mengubah implementasi CAPTCHA.
Pisahkan tinjauan aksesibilitas dari evaluasi pengenalan. Diskusi W3C tentang ketidakaksesan CAPTCHA menjelaskan penghalang yang diciptakan oleh mekanisme tantangan. Menambahkan solver ke alur QA otomatis tidak menunjukkan bahwa formulir publik menawarkan pengalaman yang aksesibel. Pemilik situs masih perlu mengevaluasi alternatif pengguna yang tepat.
Untuk penjelasan yang lebih luas tentang lapisan pengenalan, lihat bagaimana API pengenalan gambar cocok untuk otomatisasi CAPTCHA khusus. Kembali ke perbandingan ini saat memilih kontrak tugas yang tepat.
Mulailah dengan tugas CapSolver yang didukung, set uji kecil yang diberi label, dan pemroses yang mempertahankan hasil yang telah didokumentasikan. Perluas cakupan hanya setelah setiap keluarga input baru memiliki kriteria penerimaan yang jelas.
FAQ
P: Apakah VisionEngine menggantikan ImageToTextTask?
VisionEngine bukan pengganti universal. Pilih tugas yang modulnya telah didokumentasikan mendukung input dan memberikan hasil yang diharapkan aplikasi Anda. Bentuk respons dan kebutuhan gambar yang berbeda dapat memerlukan adapter yang berbeda.
P: Apakah VisionEngine selalu mengembalikan koordinat?
VisionEngine tidak selalu mengembalikan koordinat. Contoh modulnya mencakup hasil geometris dan contoh OCR yang mengembalikan teks. Baca kontrak respons modul yang dipilih alih-alih menebaknya dari nama keluarga tugas.
P: Apakah kedua keluarga tugas ini memerlukan polling getTaskResult?
Kedua referensi keluarga tugas yang terkait menggambarkan hasil yang dikembalikan langsung melalui createTask. Wrapper API yang bersama harus mempertahankan solusi langsung alih-alih memulai loop polling otomatis.
P: Dapatkah jawaban yang dikenali membuktikan bahwa formulir CAPTCHA berfungsi?
Jawaban yang dikenali tidak membuktikan pengiriman hasil yang benar atau penyelesaian formulir. Validasi jawaban terhadap fixture, lalu periksa apakah aplikasi yang dikelola mengonsumsinya untuk tantangan yang tepat dan mencapai hasil yang diharapkan.
Lihat Lebih Banyak
The Other CAPTCHASep 15, 2026
Pemecah CAPTCHA Pemindaian vs Webhooks: Bagaimana Memilih Alur Hasil
Pilih pemecah CAPTCHA polling atau webhooks menggunakan status tugas, persyaratan penerima, kebaruan hasil, dan alur penyelesaian API CapSolver yang didokumentasikan.
The Other CAPTCHASep 09, 2026
Keamanan Integrasi CAPTCHA Selenium: Lindungi Kunci dan Sesi
Pelajari cara melindungi kunci, sesi, log, dan lingkungan pengujian dalam integrasi CAPTCHA Selenium, dengan pemeriksaan ulasan praktis untuk otomatisasi yang diizinkan.
